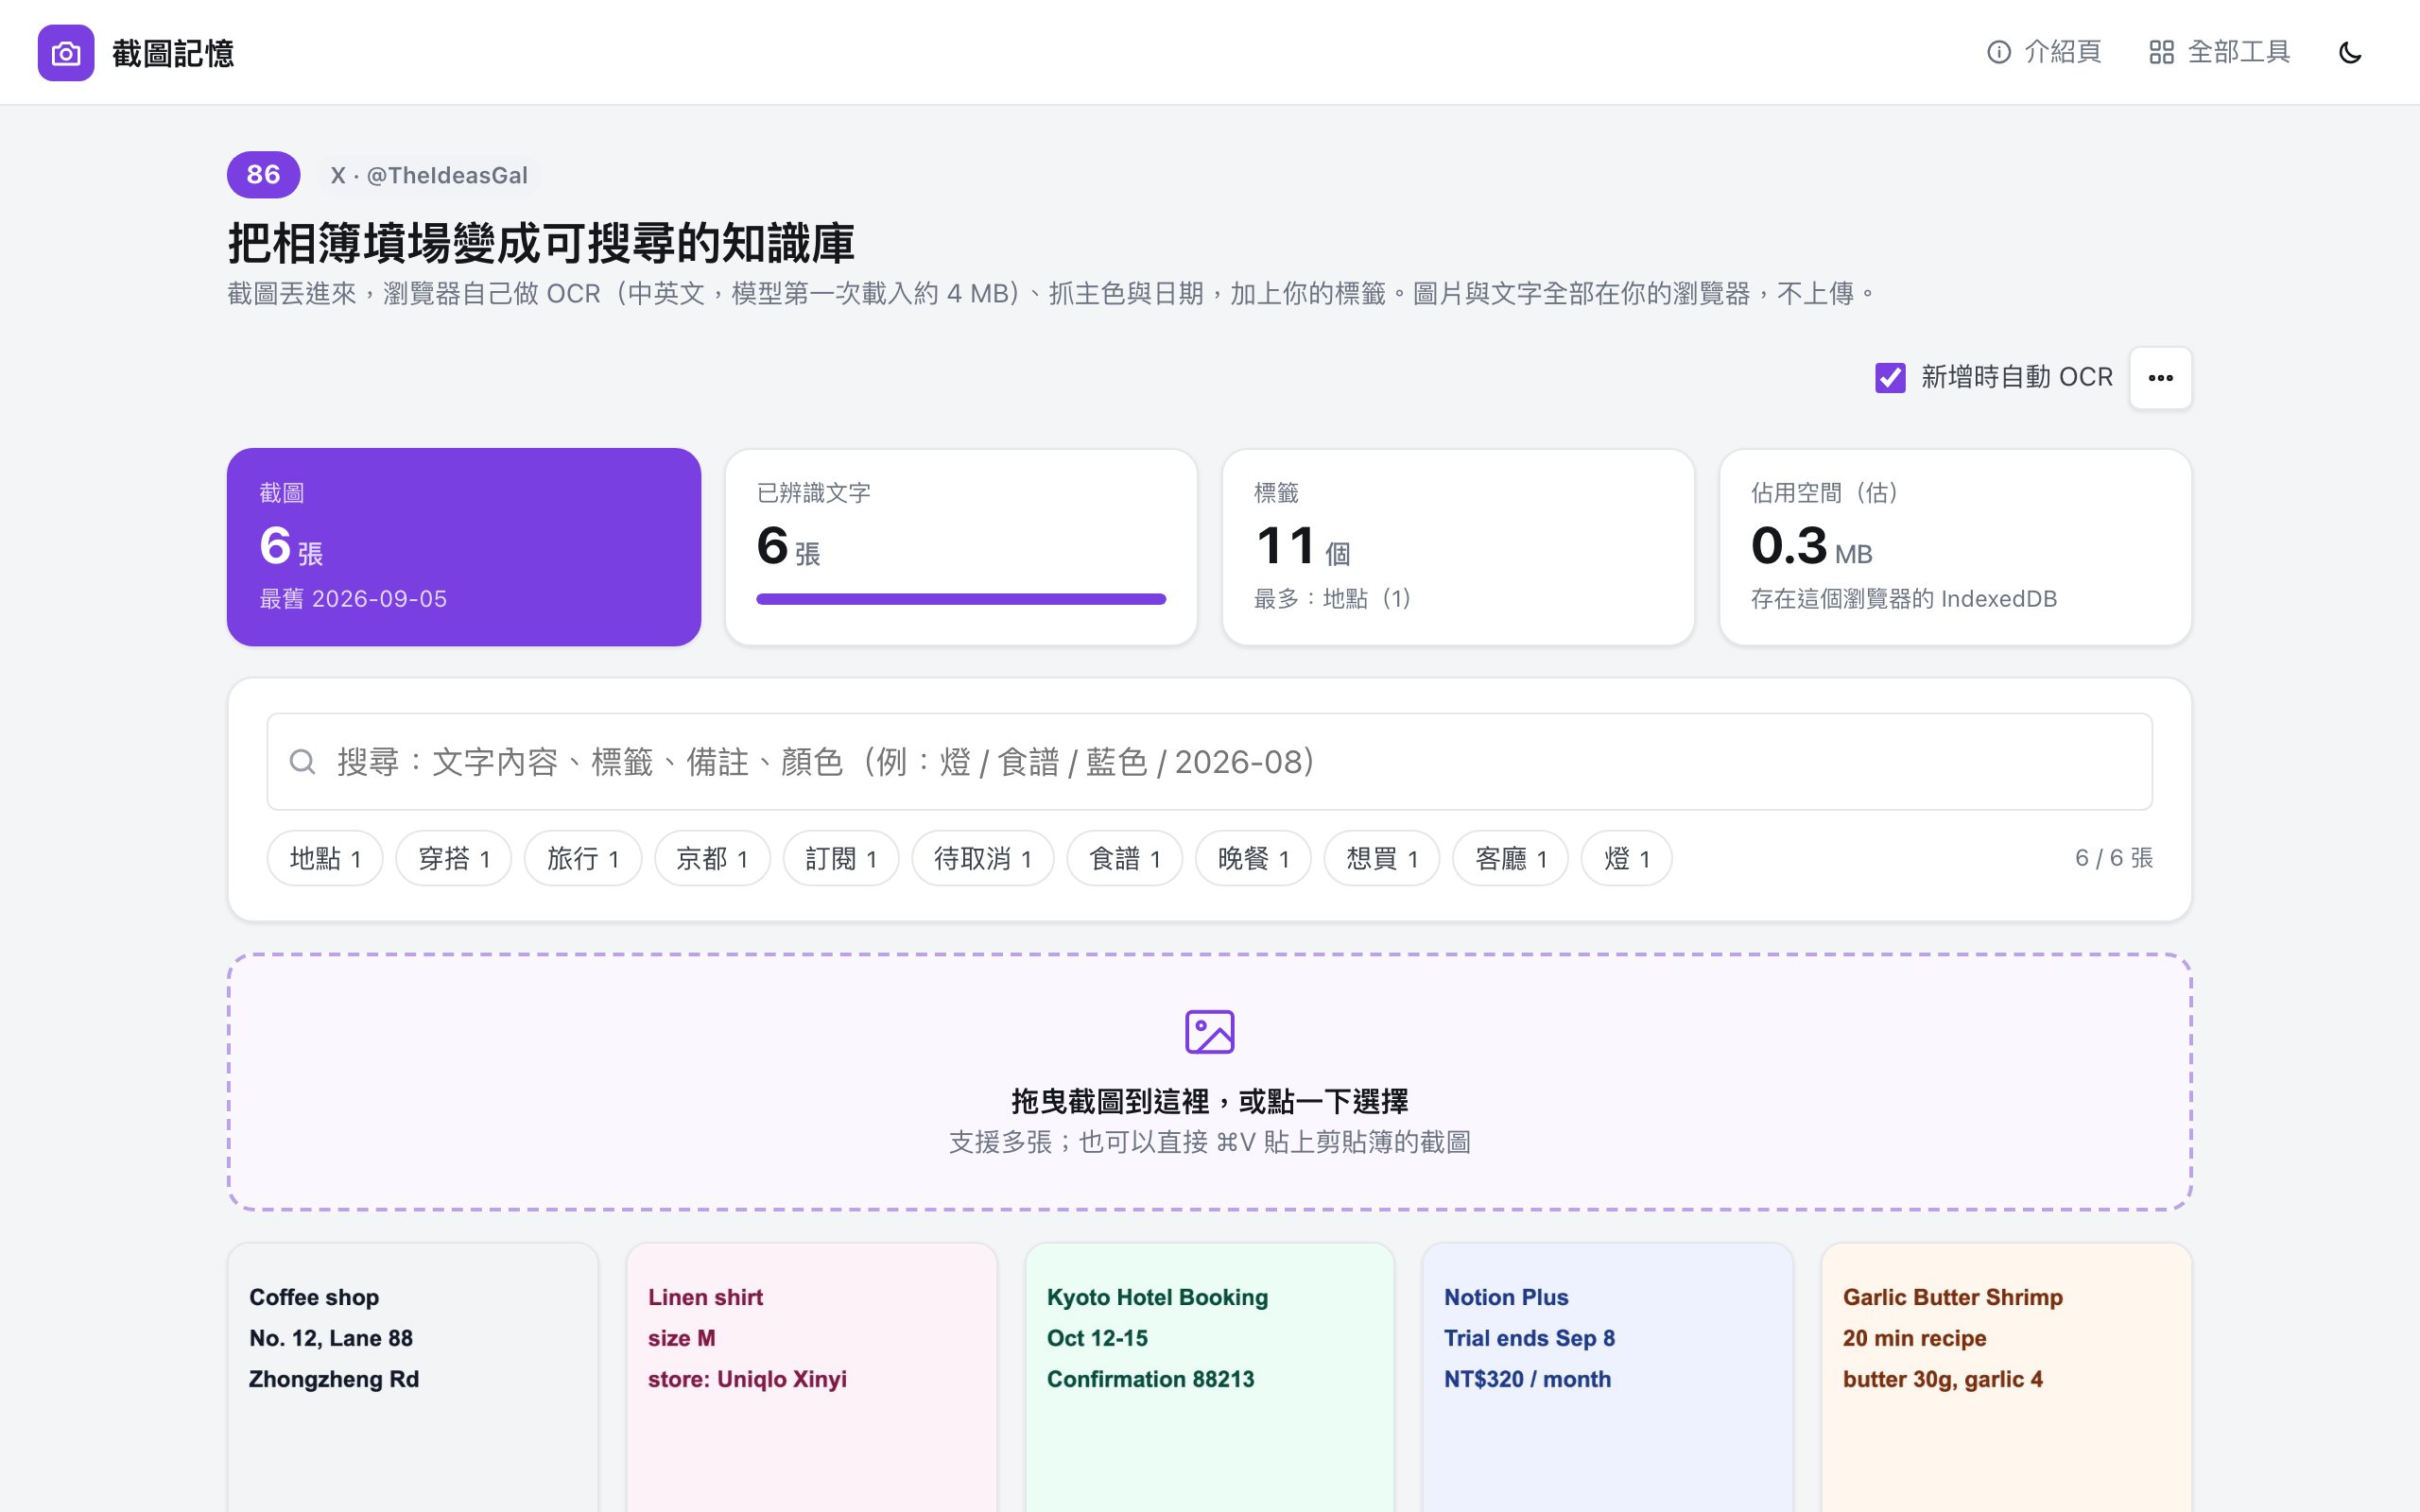
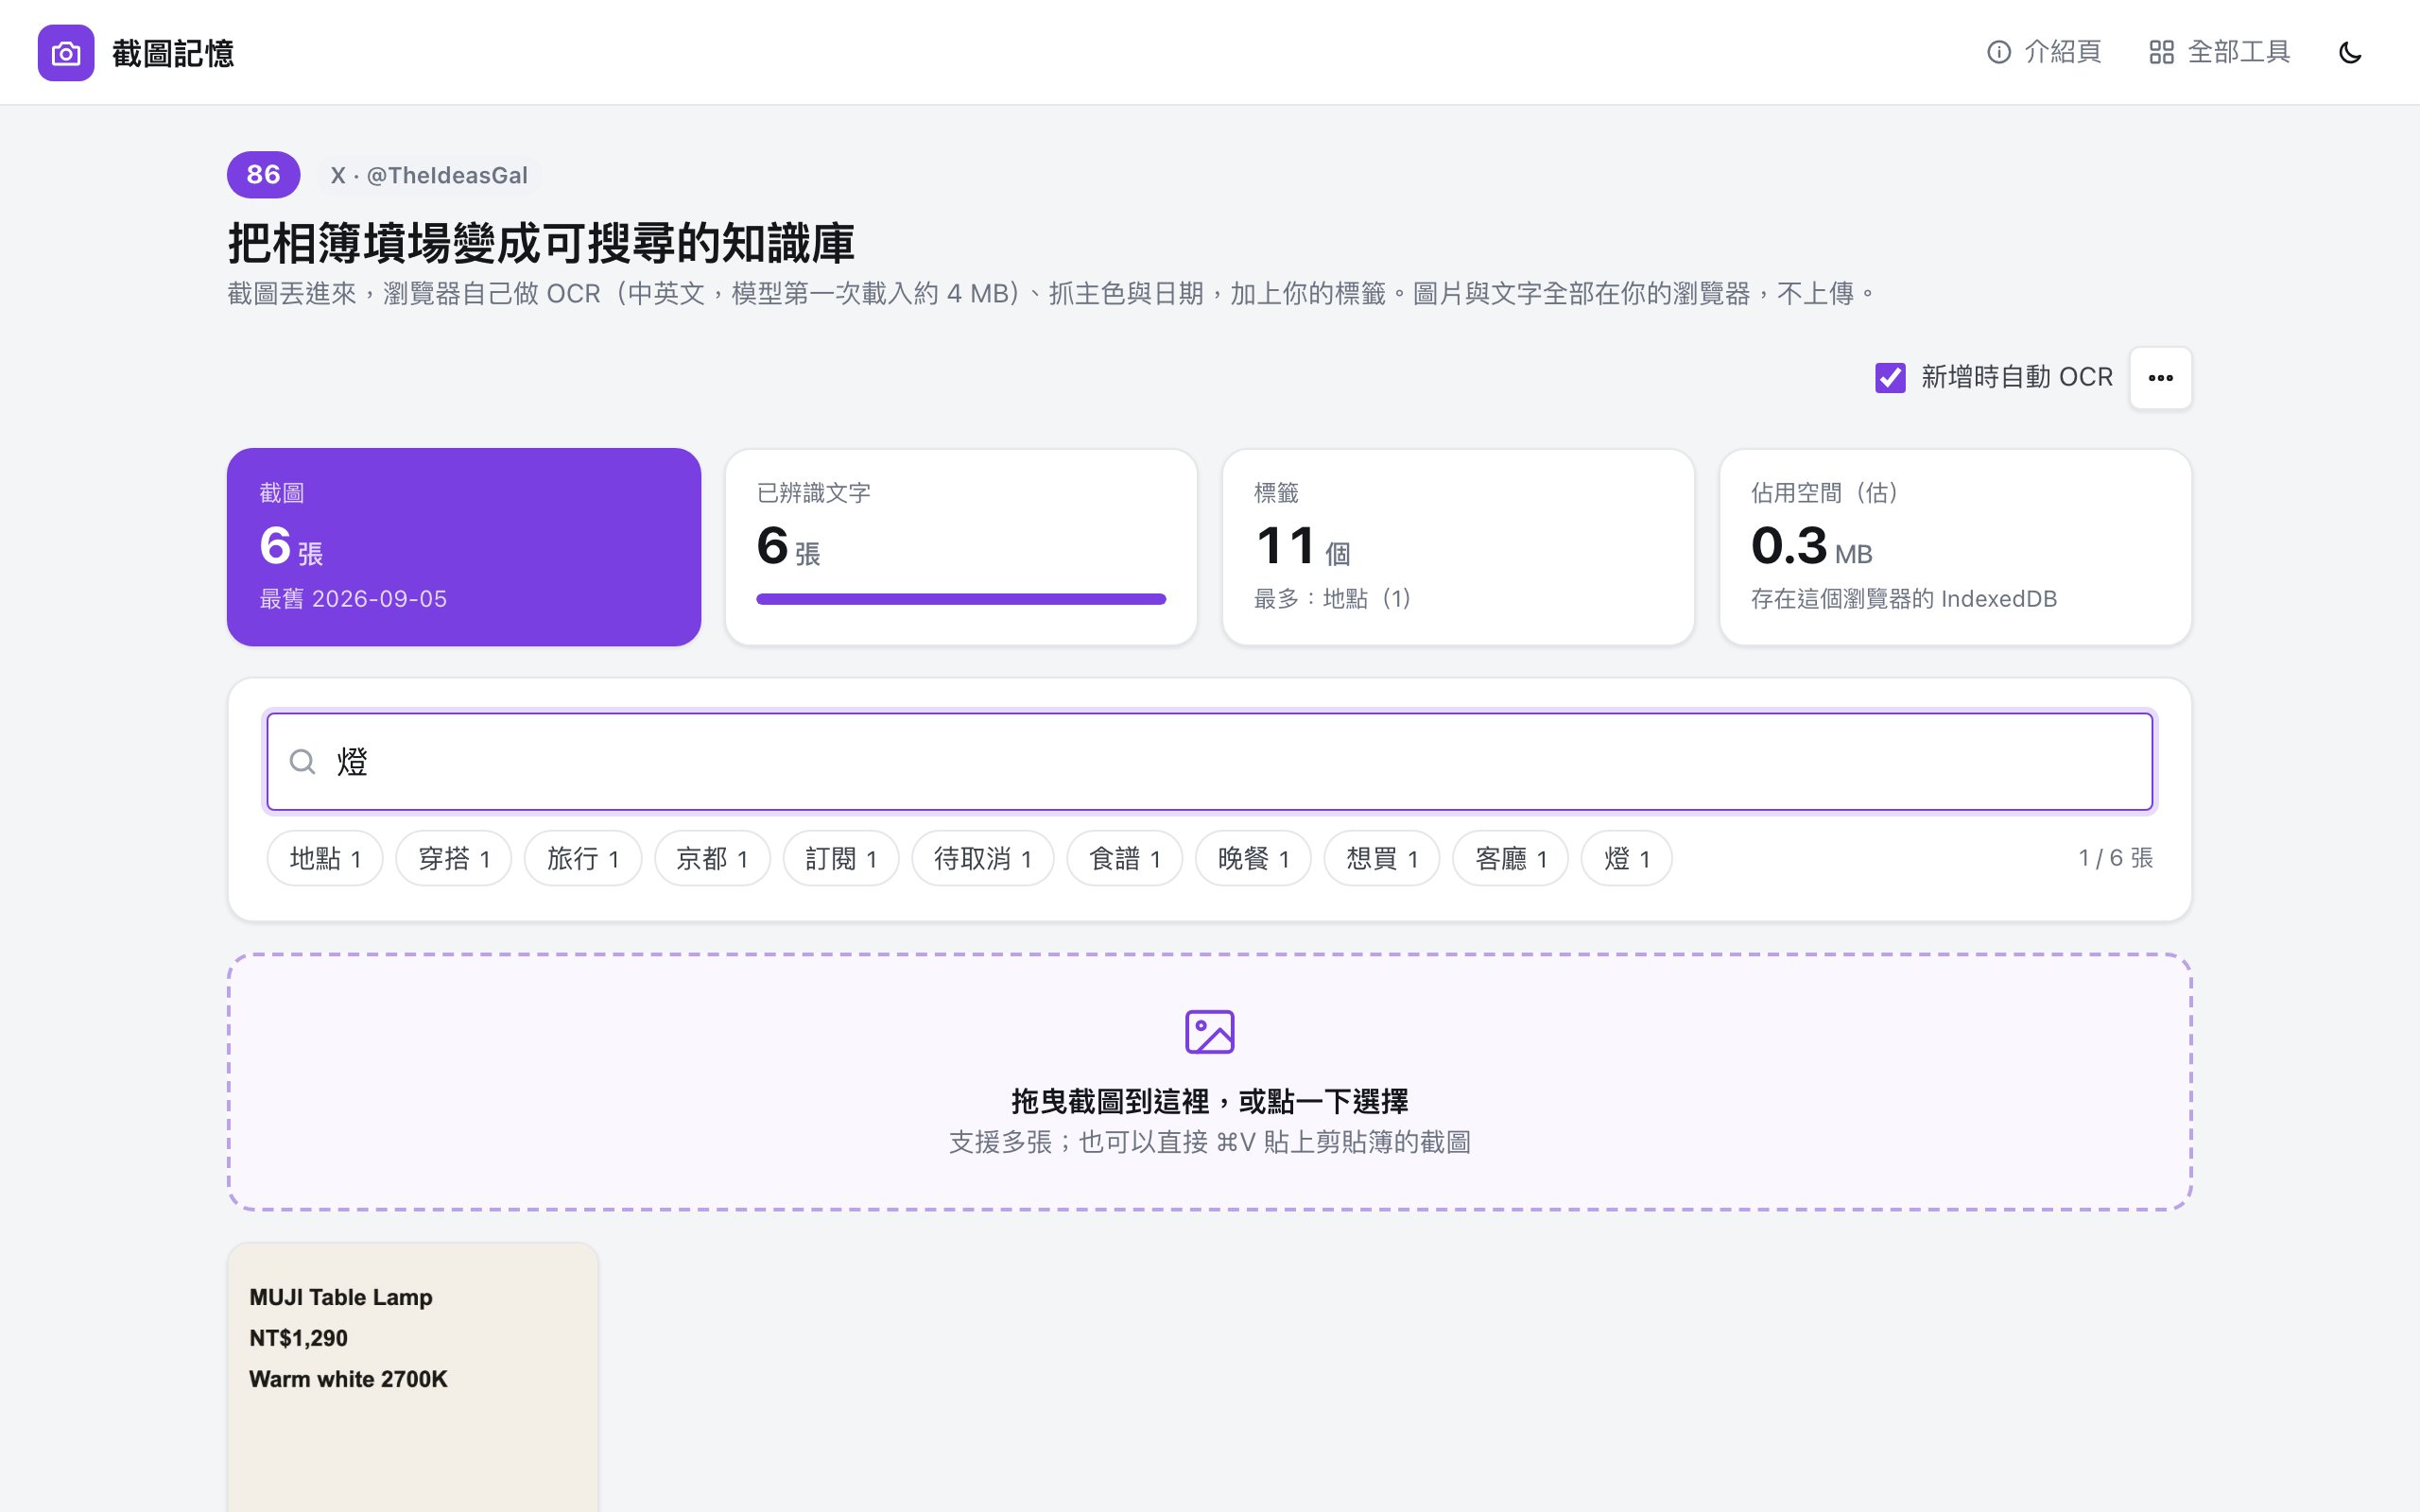
商品、凌晨的點子、食譜、穿搭、地址,全都截圖了,然後再也沒看過。把截圖丟進來,它讀出上面的文字、抓出顏色、記下日期。之後打「那盞燈」「藍色」「食譜」,就出現。

截圖是最快的「先存起來」。問題出在找回來:相簿只能按日期滑,你記得的是內容,不是日期。
兩週後想買,相簿往回滑 400 張,放棄。
你記得是綠色的招牌、在巷子裡,但截圖上的店名要一張一張點開看。
「蒜香奶油蝦」四個字就在截圖上,但相簿搜尋看不懂圖片裡的字。
截圖裡寫著「9 月 8 日試用結束」,但沒有人會去相簿裡翻提醒。
要交的東西寫在那張截圖裡,混在 200 張迷因中間。
不知道哪些重要,所以全部留著。
截圖不該是圖片,該是一則能搜尋的筆記。
丟進來的當下讀出文字、顏色、日期;之後用你記得的方式找。每一件都在你的瀏覽器裡完成,圖片沒有離開這台裝置。
用自架的 tesseract.js 在瀏覽器裡辨識。模型第一次載入約 4 MB,之後快取。
每張截圖抓四個主色,翻成中文色名。找「那個藍色的 App」就靠它。
多個關鍵字用空白隔開,全部符合才出現。命中的標籤會反白。
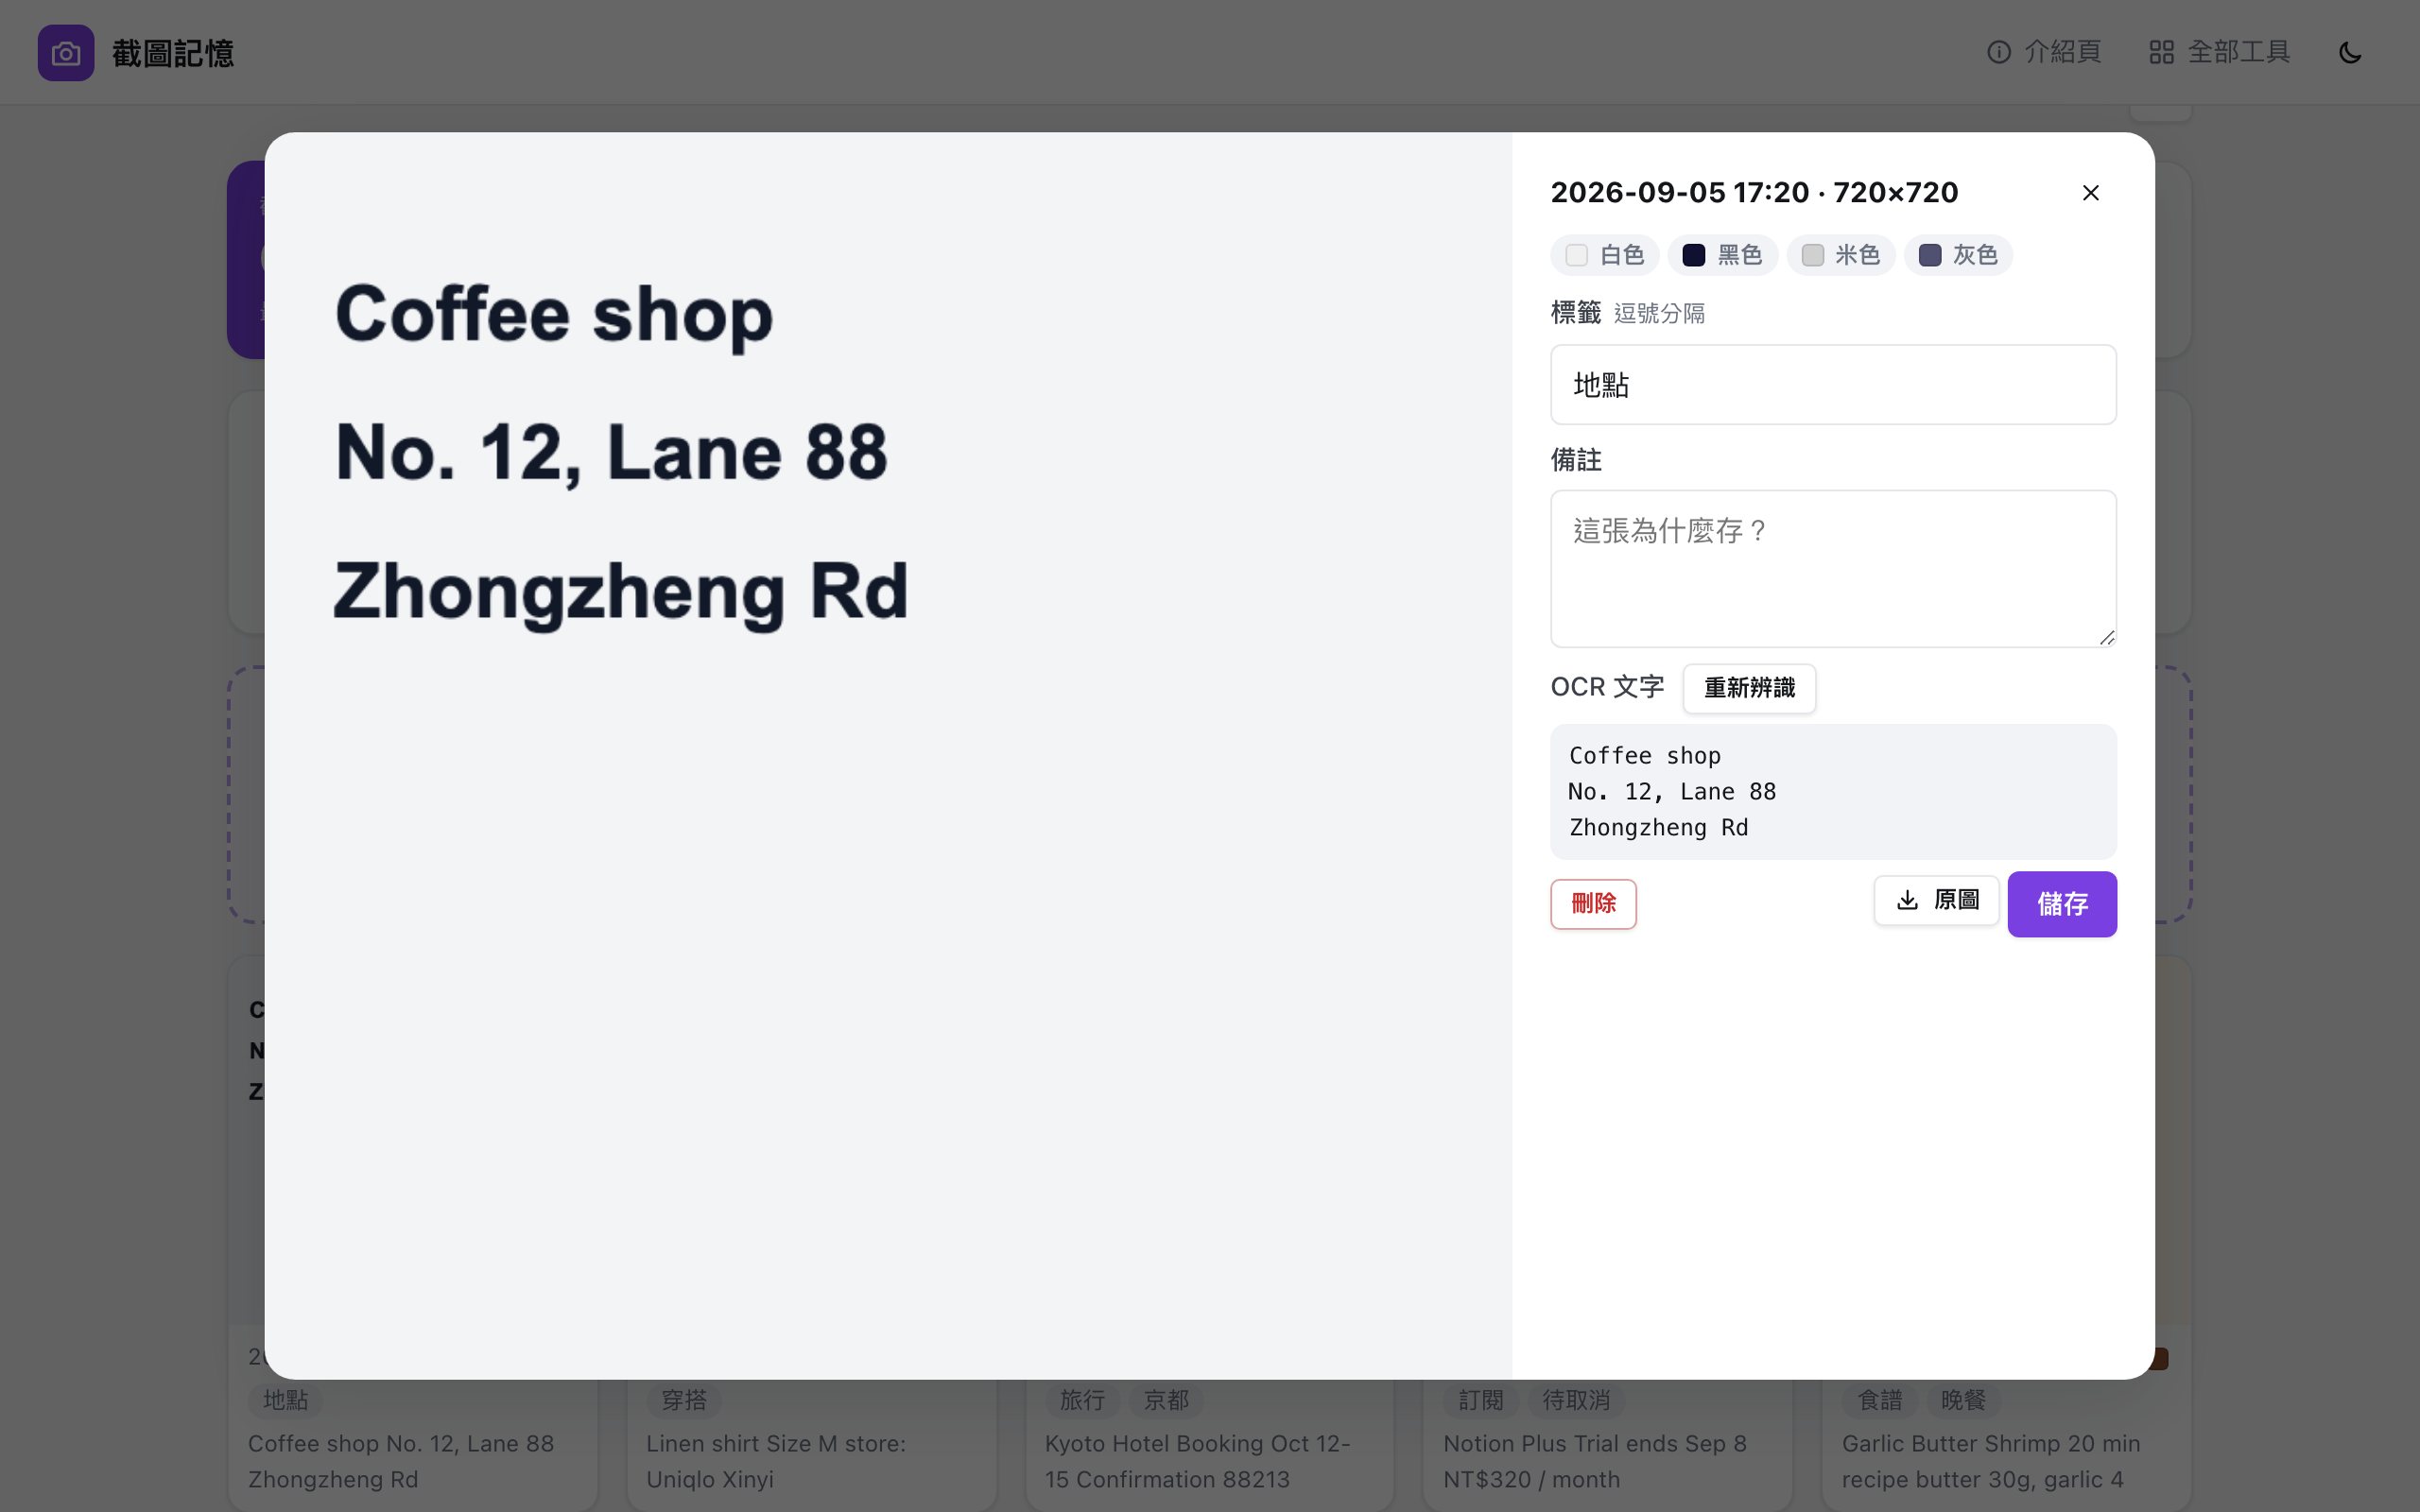
打開任何一張,輸入標籤與備註。標籤也會被搜尋。
一次可以丟幾十張,背景排隊辨識。
可以匯出索引 JSON(文字與標籤,不含圖片)。
第一張約 10 秒(含載入模型),之後每張 2 到 5 秒。
支援多張。立刻產生縮圖、抓主色、記下檔案日期。
看得到:卡片出現,標「待辨識」進度條跑完,卡片下方出現讀到的文字。辨識失敗可以「補跑」。
看得到:卡片顯示前兩行文字「想買, 客廳, 燈」。這一步可跳過,OCR 文字本身就能搜。
看得到:標籤顯示在卡片上「燈」「1290」「藍色」「2026-09」。多字用空白隔開。
看得到:命中的截圖與反白的關鍵字
辨識準確度取決於截圖:清楚的螢幕文字很準,手寫、斜拍、花底圖會掉。
功能正確有測試;市場需求有來源貼文;使用者見證還沒有,就寫還沒有。

端到端測試:上傳合成圖、等辨識、搜尋命中。正式站 6 秒完成。
「相簿裡上萬張截圖變成墳場,希望截圖當下 AI 讀取、標籤,之後用自然語言找回。」這裡的做法就照這句話。
剛上線。等有人放進 500 張截圖並找回東西再放。
沒有雲端版、沒有帳號。這是刻意的:你的截圖裡有太多私事。
在電腦瀏覽器效果最好(拖曳、貼上、大量處理)。手機也能用,辨識較慢。
「–」開頭的是刻意不做、或網頁做不到的。寫在這裡,免得你打開才發現。
答案先講,條件後講。